Работающее AI-приложение складывается из модели, данных, интерфейса, правил доступа и способа проверить результат. Подключение API решает только часть задачи. Ответ может выглядеть убедительно, но ссылаться на старую инструкцию, раскрывать чужой документ или предлагать действие, которое пользователь не вправе выполнять.
Десять схем ниже помогают разобраться в основных направлениях AI-инженерии: от типов моделей до эксплуатации приложения. Читать их стоит как карту понятий. Некоторые категории пересекаются, а отдельные стрелки обозначают возможный выбор, а не обязательную последовательность разработки.
Для практического разбора возьмём учебный пример: ассистента по документации CMS. Сотрудник спрашивает, как опубликовать страницу, настроить роль или восстановить резервную копию. Система должна найти актуальную инструкцию, учесть права сотрудника и показать проверяемый ответ. Это пример проектирования, а не заявление о внедрённом продукте или достигнутых показателях DDRW.
1. Типы моделей: сначала задача, затем инструмент
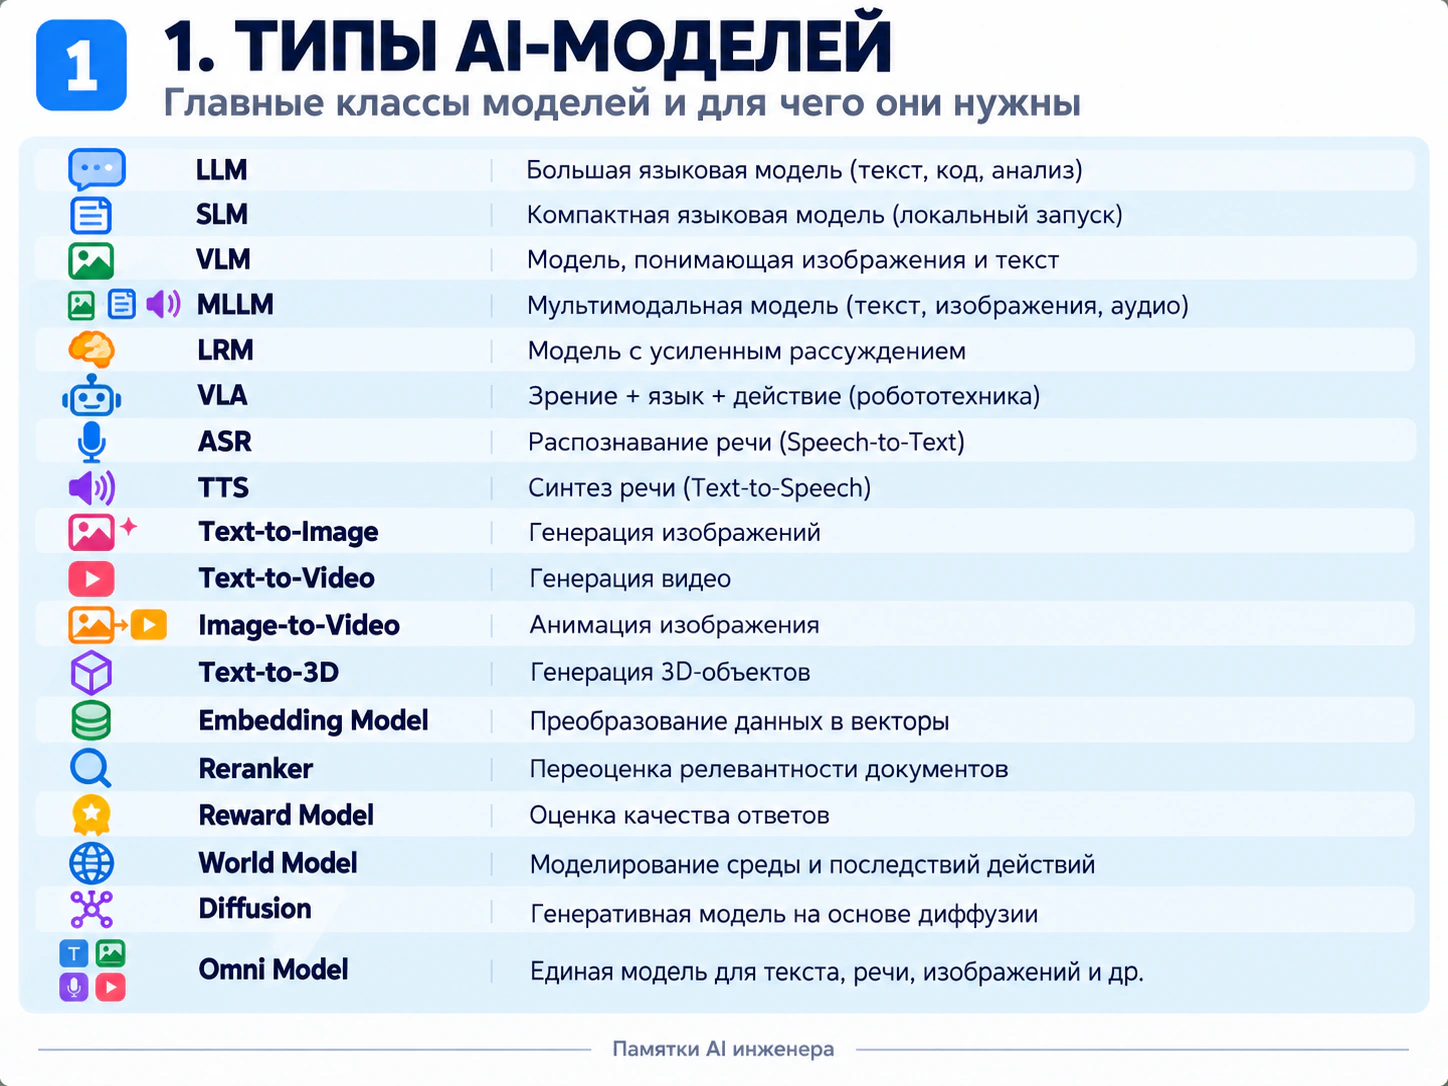
Сравнивать модели полезно по нескольким независимым признакам. Один описывает входные данные: текст, изображение, звук или их сочетание. Другой — ожидаемый результат: классификация, поиск, генерация, распознавание. Третий — доступный способ использования: внешний API или самостоятельное размещение.
Языковая модель может подготовить ответ, embedding-модель — представить запрос и документ в виде векторов для поиска, reranker — переупорядочить найденные фрагменты по соответствию вопросу. Это разные роли; большая генеративная модель не обязана выполнять их все.
Категории также могут пересекаться. Мультимодальная модель бывает одновременно генеративной и способной обрабатывать текст. Модель с доступными весами не обязательно разрешена для любого коммерческого применения: отдельно проверяются лицензия, ограничения использования и условия поставки.
Для нашего ассистента сначала достаточно выбрать способы поиска и генерации текста. Распознавание изображений понадобится, если важные инструкции существуют только в скриншотах. До выбора полезно собрать реальные вопросы и примеры документов: по ним видно, какая функция действительно нужна.
Сравниваем кандидатов на одинаковых заданиях: правильность ответа, русский язык, формат результата, задержка, стоимость и допустимость обработки данных. Не выбираем исключительно по числу параметров или месту в общей таблице: они не описывают полностью конкретный сценарий CMS.
2. Архитектуры: не все блоки относятся к одному уровню
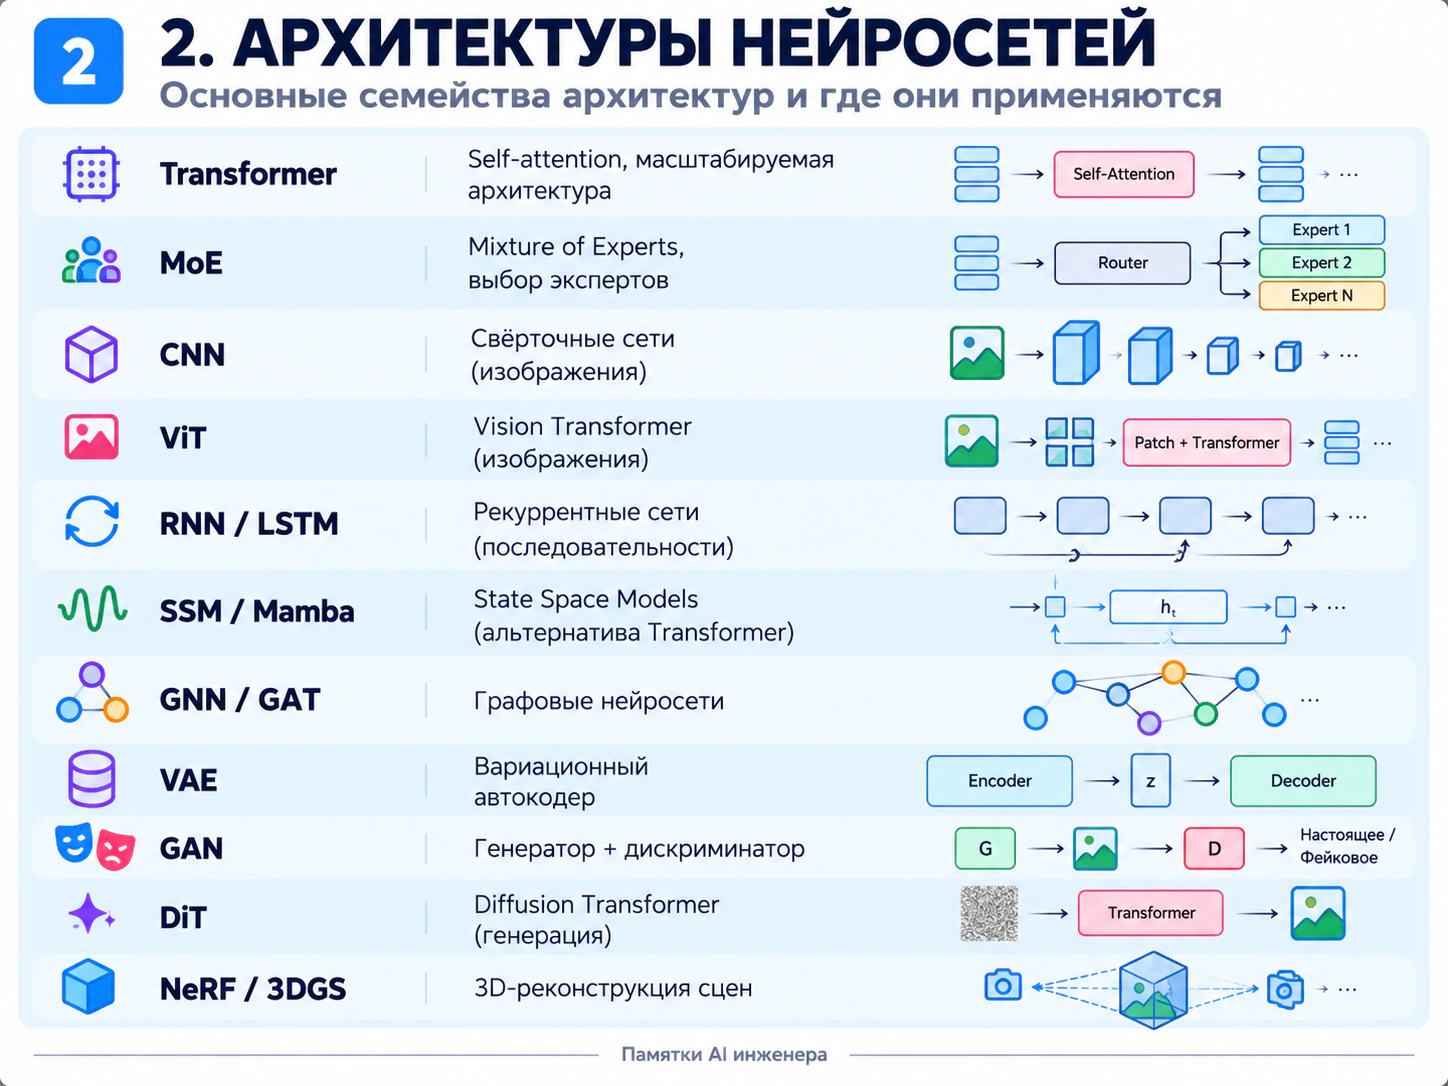
Transformer описывает организацию нейросетевых вычислений с механизмом внимания. Encoder, decoder и их сочетания задают разные способы обработки последовательностей. Для прикладной команды это влияет на совместимость с задачей, доступные интерфейсы и требования к запуску.
MoE, или смесь экспертов, может быть устройством отдельных слоёв внутри модели. Поэтому «Transformer или MoE» — не всегда корректная развилка: Transformer может использовать экспертные блоки. Число всех параметров и объём вычислений для одного запроса при этом не одно и то же.
Модели пространства состояний, SSM, относятся к моделированию последовательностей. Например, в исследовании Mamba предложены селективные механизмы передачи состояния. Это отдельное направление, которое нельзя свести к другому названию внимания. Исследование Mamba.
3D Gaussian Splatting находится на другом уровне карты: это представление и способ оптимизации и визуализации трёхмерной сцены с использованием гауссовых примитивов. Ставить его в один сравнительный ряд с языковой архитектурой без пояснения задачи неправильно. Исследование 3D Gaussian Splatting.
При выборе готовой модели для документации нет необходимости самостоятельно проектировать архитектуру. Важнее проверить её поведение и ограничения в нашем приложении. Архитектурная грамотность помогает задать поставщику правильные вопросы и не сравнивать решения, предназначенные для разных задач.
3. Reasoning: дополнительные вычисления требуют проверки результата
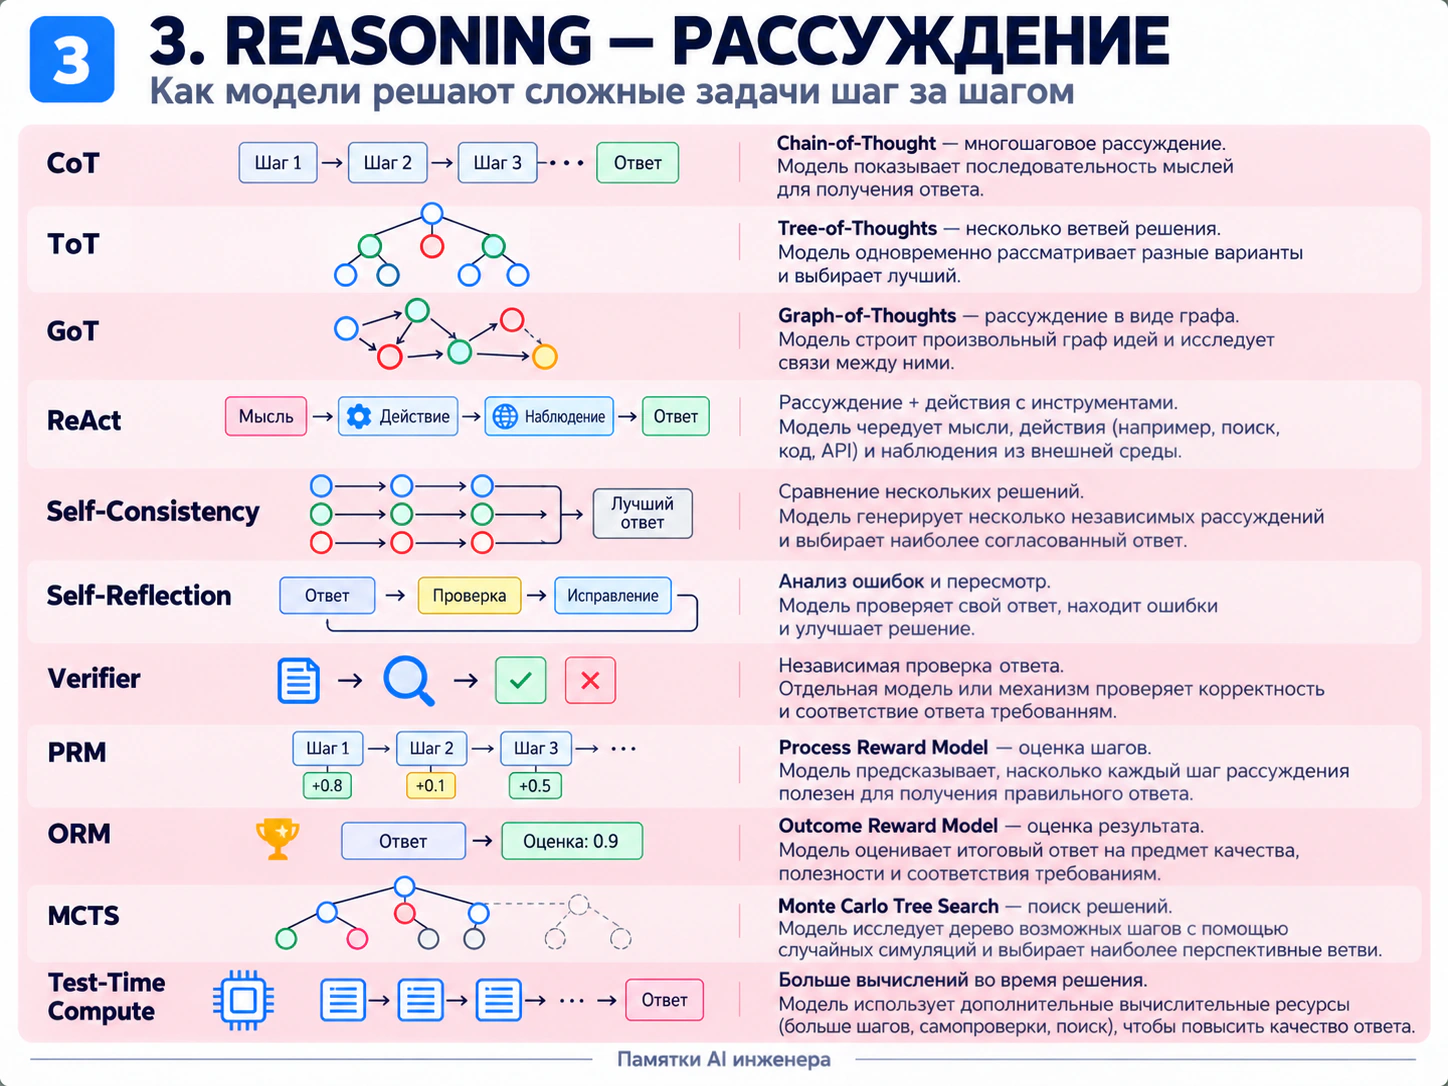
Под reasoning обычно понимают работу над задачей с промежуточными шагами: разбор условий, выбор действия, проверку варианта. Это может быть полезно, если ответ требует сопоставить несколько инструкций. Но дополнительное время обработки само по себе не подтверждает правильность.
Chain of Thought, или цепочка рассуждений, описывает промежуточные текстовые шаги. В прикладном API доступ к ним зависит от модели и поставщика. Например, OpenAI описывает внутренние reasoning-токены, которые не показываются пользователю напрямую, и отдельно — доступные сводки. Документация reasoning.
Даже подробное объяснение ответа не следует считать точным журналом внутренних вычислений. Для аудита нужны наблюдаемые сведения: использованные документы, вызванные инструменты, переданные параметры и результат внешней проверки.
Вопрос «Как опубликовать страницу?» обычно не требует сложной многошаговой системы. Достаточно найти подходящую инструкцию. Для вопроса о несовпадении черновика и опубликованной версии могут понадобиться уточнение роли и версии CMS, затем сопоставление нескольких разделов.
Задаём предел времени и вычислений. Если задача не решается в бюджете, ассистент возвращает найденные сведения, обозначает неопределённость или предлагает обратиться к администратору. Для числового расчёта предпочтительнее проверяемый инструмент, а не длинное текстовое рассуждение модели.
4. RAG: передать найденные сведения в контекст
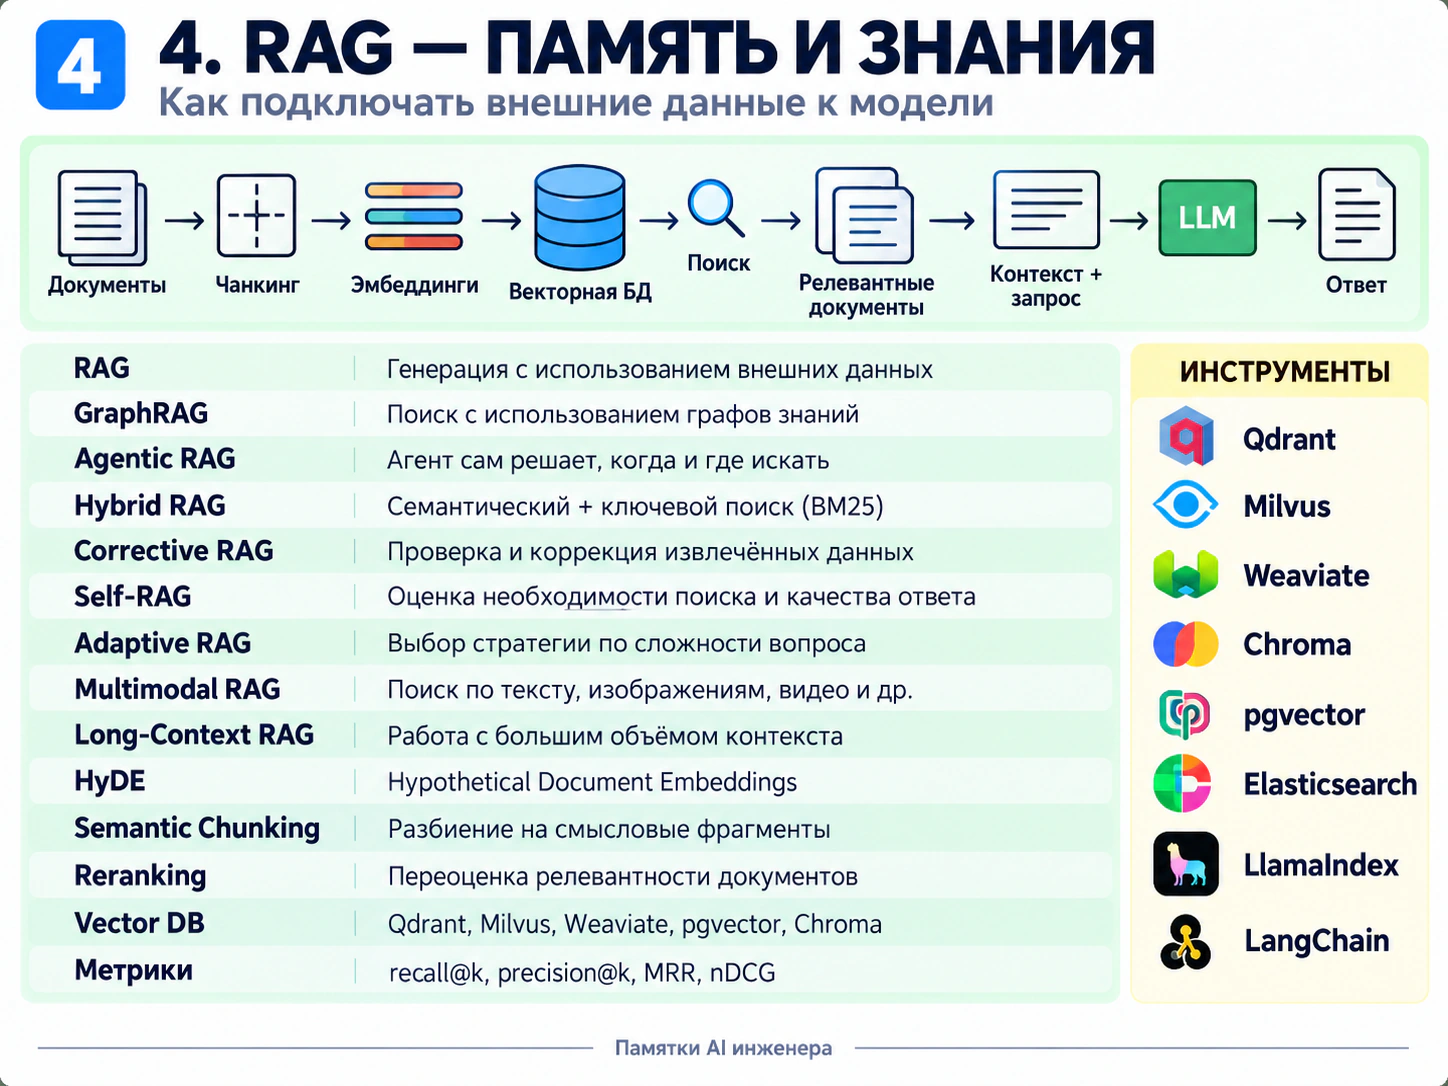
RAG связывает поиск внешних материалов с генерацией ответа. В типичном прикладном варианте система находит фрагменты, передаёт их модели и просит ответить с опорой на эти источники. Передача документов в контекст не меняет веса модели. Историческая исследовательская работа о RAG также рассматривает обучение компонентов, поэтому термин шире одного готового шаблона интеграции. Исследование Retrieval-Augmented Generation.
Практический процесс начинается раньше запроса. Документы нужно извлечь из источников, очистить от технического шума, разделить на осмысленные фрагменты и снабдить метаданными: адресом, заголовком, версией, датой и правилами доступа.
Для CMS полезен комбинированный поиск. Точное название поля или код ошибки хорошо искать по словам; смысловой вопрос — с помощью векторного представления. Затем можно переупорядочить найденное и выбрать ограниченный набор фрагментов для ответа.
Права применяются до передачи материалов модели. Недостаточно попросить ассистента «не показывать секретные документы»: закрытый фрагмент вообще не должен оказаться в доступном ему контексте. Те же ограничения нужны для заголовков, сниппетов и кеша.
RAG не гарантирует истину. Поиск способен найти устаревшую страницу, пропустить нужную или вернуть противоречивые версии. Поэтому ответу нужны ссылки на использованные разделы, а системе — правила обновления и удаления индекса. Если подтверждения нет, полезнее уточнить версию CMS или сообщить, что инструкция не найдена, чем заполнять пробел догадкой.
5. Агенты, MCP и A2A: разделяем подключение и полномочия
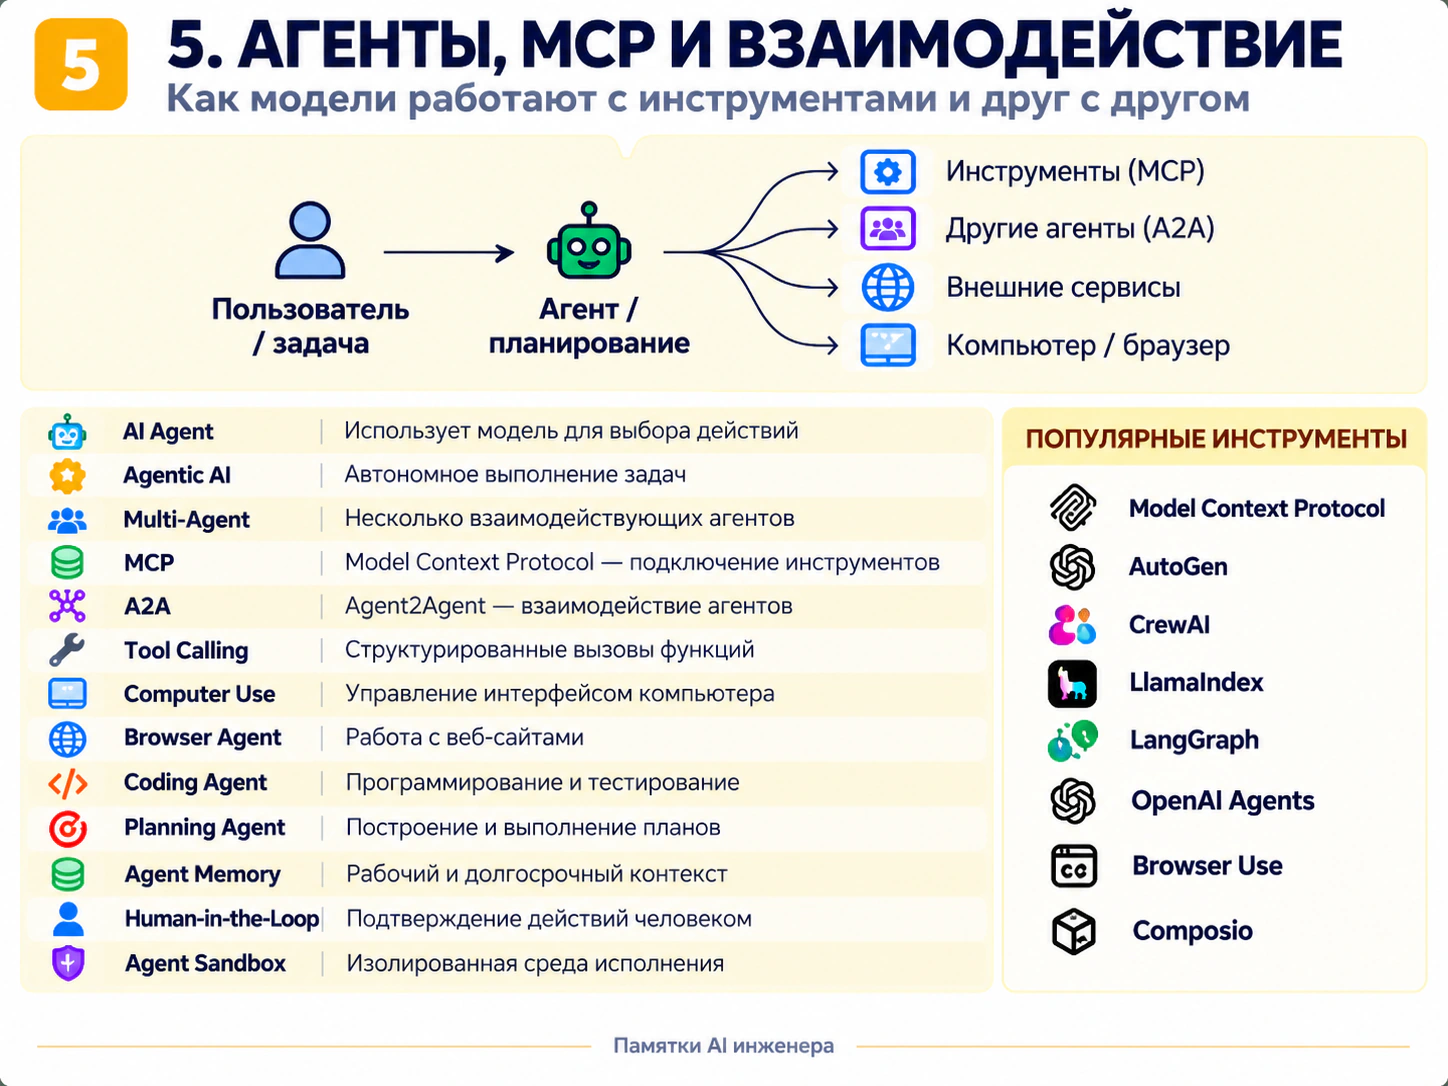
Агентный подход нужен, когда модель не только формулирует ответ, но и выбирает следующие действия. Например: найти инструкцию, уточнить параметры, запросить состояние страницы и подготовить предложение об исправлении. Цикл требует явного условия завершения.
MCP стандартизирует подключение инструментов и источников контекста. A2A описывает взаимодействие самостоятельных агентов: обнаружение возможностей, передачу задач и результатов. Протоколы дополняют друг друга, но не заменяют серверные проверки прав. Это различие прямо разобрано в спецификации A2A.
Для ассистента CMS разумно начать с разрешённого списка инструментов: поиск документации и чтение доступного пользователю состояния. Произвольный SQL, запуск команд сервера и универсальный HTTP-клиент для такого сценария избыточны.
Каждый инструмент получает типизированные параметры, ограниченный ответ и контекст проверенного пользователя. Идентификатор пользователя нельзя брать из произвольного текста, предложенного моделью. Операции публикации или изменения доступа требуют отдельного разрешения и, где нужно, подтверждения человеком.
Задаём бюджеты числа шагов, времени, токенов и расходов. Повторный запрос после сетевого сбоя не должен повторно публиковать страницу или отправлять письмо: изменяющие операции требуют идемпотентности либо другого механизма безопасного повтора.
Несколько агентов имеют смысл, если задачи действительно разделимы. Для поиска одной инструкции дополнительный посредник чаще усложняет журналирование и обработку ошибок. Сначала проверяем простой управляемый процесс, затем добавляем автономность там, где она приносит измеримую пользу.
6. Обучение: отдельное решение после проверки базового подхода
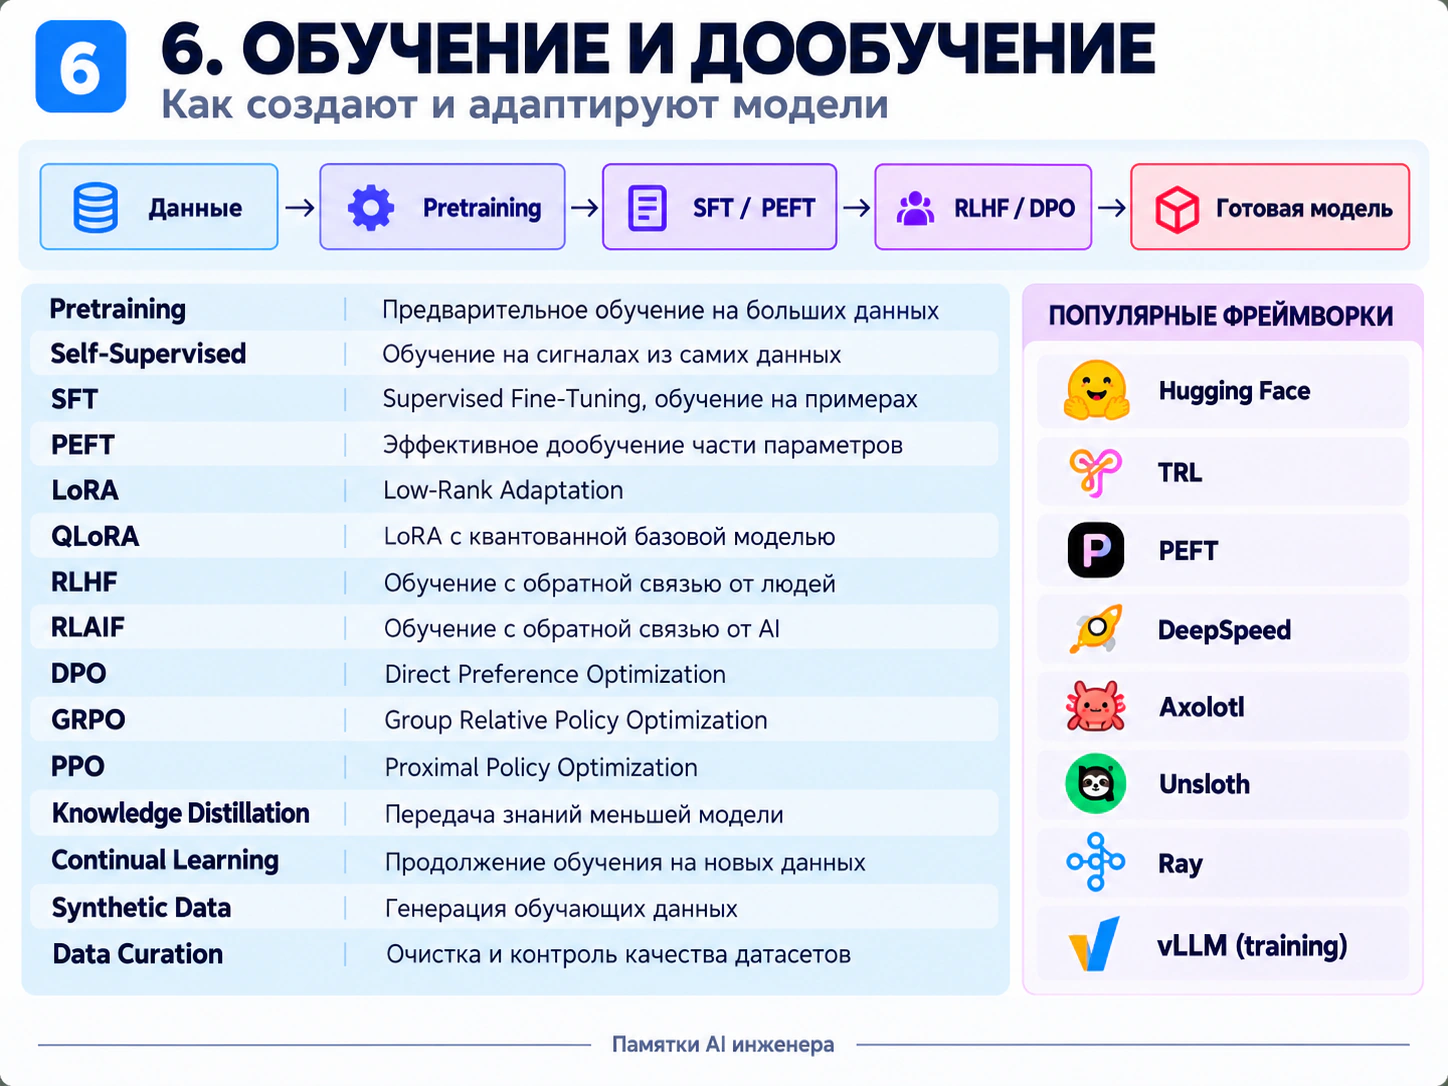
Предобучение создаёт базовые способности модели на большом корпусе. SFT, обучение на примерах входа и желаемого ответа, помогает адаптировать поведение под задачу. Для компании с документацией CMS самостоятельное предобучение обычно не является стартовым шагом: сначала стоит проверить готовую модель, инструкции и поиск.
PEFT объединяет методы адаптации с изменением сравнительно небольшой части параметров. LoRA относится к этому семейству: базовые веса замораживаются, а обучаются дополнительные низкоранговые матрицы. Поэтому LoRA и PEFT нельзя представлять как несвязанные альтернативы. Исследование LoRA.
RLHF с обучаемой моделью награды и последующей оптимизацией, а также DPO — разные подходы к использованию предпочтений. DPO не является обязательным следующим шагом после RLHF: соответствующая работа предлагает другой способ оптимизации по предпочтениям. Исследование DPO.
Если модель регулярно нарушает нужный формат даже с хорошими примерами, дообучение может стать отдельным экспериментом. Если она не знает сегодняшнюю инструкцию, сначала проверяем актуальность поиска: обучение не заменяет обновляемую базу документов.
Обучающие примеры отделяем от контрольных. Проверяем происхождение данных, разрешения и отсутствие секретов. После адаптации оцениваем не только целевую задачу, но и возможное ухудшение других нужных функций.
Упоминание vLLM в схеме обучения требует оговорки: он может обеспечивать генерацию примеров, или rollouts, внутри процесса, которым управляет отдельный trainer. Это не универсальная замена инструменту обучения.
7. Inference: обслуживать запросы с предсказуемыми ограничениями
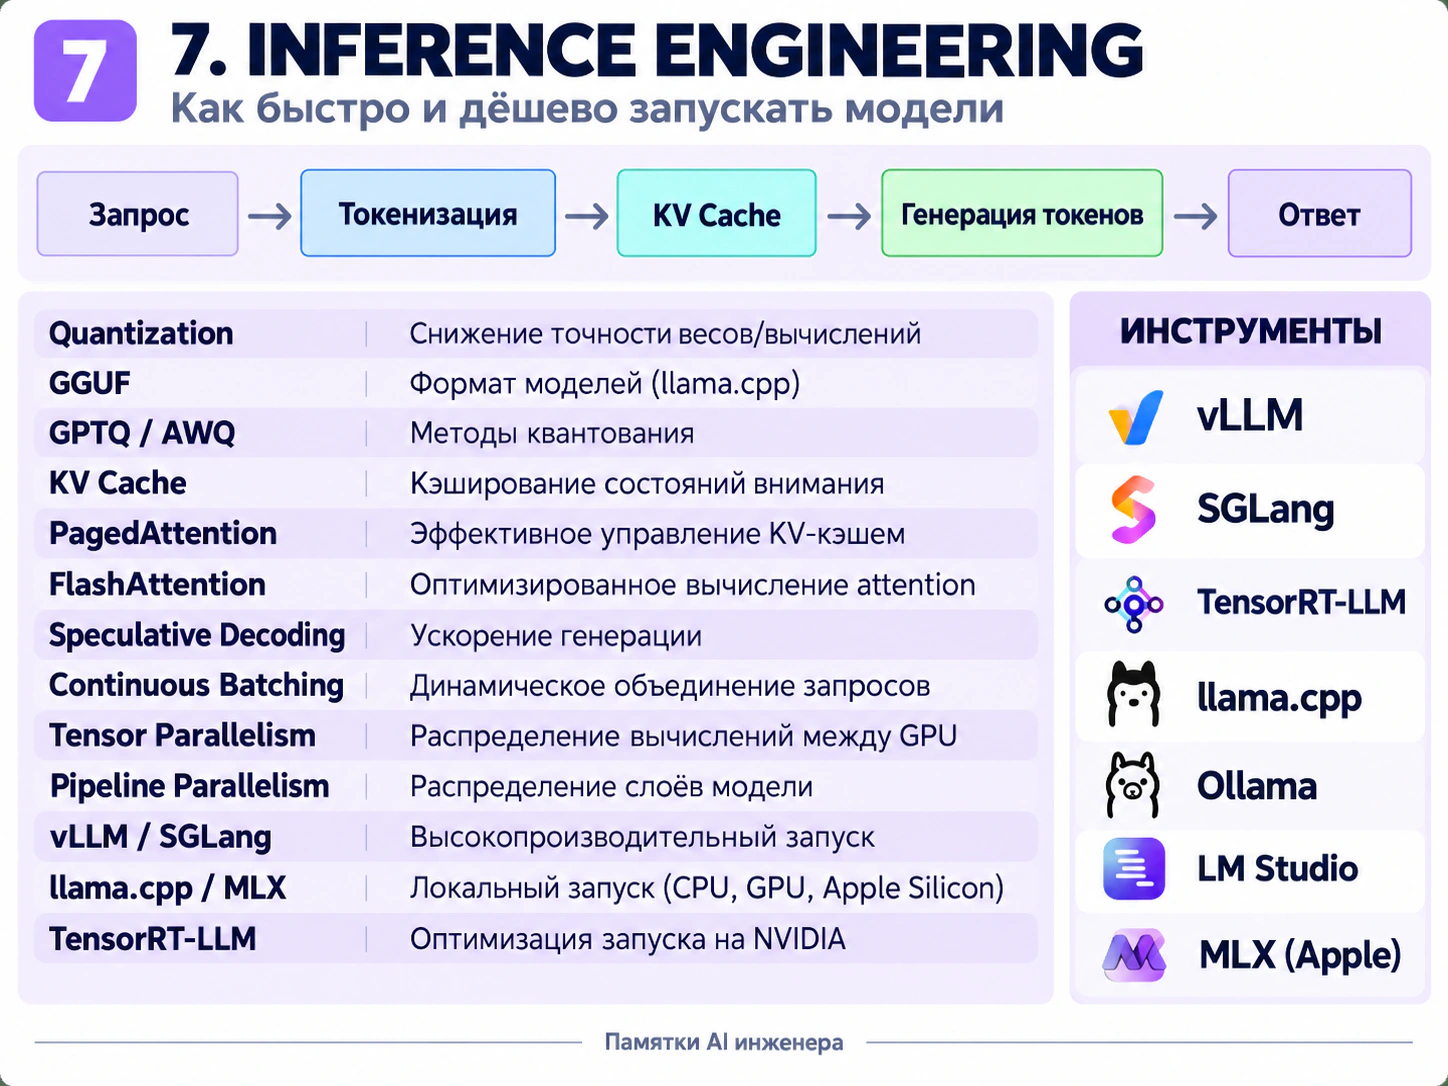
Inference — применение уже подготовленной модели. При собственном размещении приходится учитывать память устройства, параллельные запросы и очередь. Внешний API снимает часть инфраструктурных задач, но оставляет лимиты, сетевые ошибки и контроль расходов.
vLLM предназначен прежде всего для выполнения генерации и обслуживания моделей. В связке с обучающими библиотеками роли разделены: trainer обновляет веса, а сервер генерирует ответы. Это показано в документации интеграции vLLM с TRL.
KV cache хранит промежуточные ключи и значения механизма внимания, чтобы не пересчитывать уже обработанные позиции при генерации. Это вычислительная память, а не проверенная база фактов, история прав пользователя или способ обучить модель новым сведениям.
Квантование уменьшает представление чисел и может снизить требования к памяти. Пакетная обработка повышает эффективность обслуживания, но способна увеличить ожидание отдельного запроса. Любую оптимизацию проверяем на собственных примерах: уменьшение расхода памяти не должно скрывать неприемлемое изменение качества.
В ассистенте документации отдельно наблюдаем время поиска, ожидания модели и подготовки ответа. Ограничиваем длину контекста и результата, задаём тайм-ауты и отмену. Кеш готовых ответов учитывает версию документов и область доступа; одинаковый вопрос разных сотрудников не означает одинаковое право на данные.
8. Оценка и безопасность: проверять систему по частям
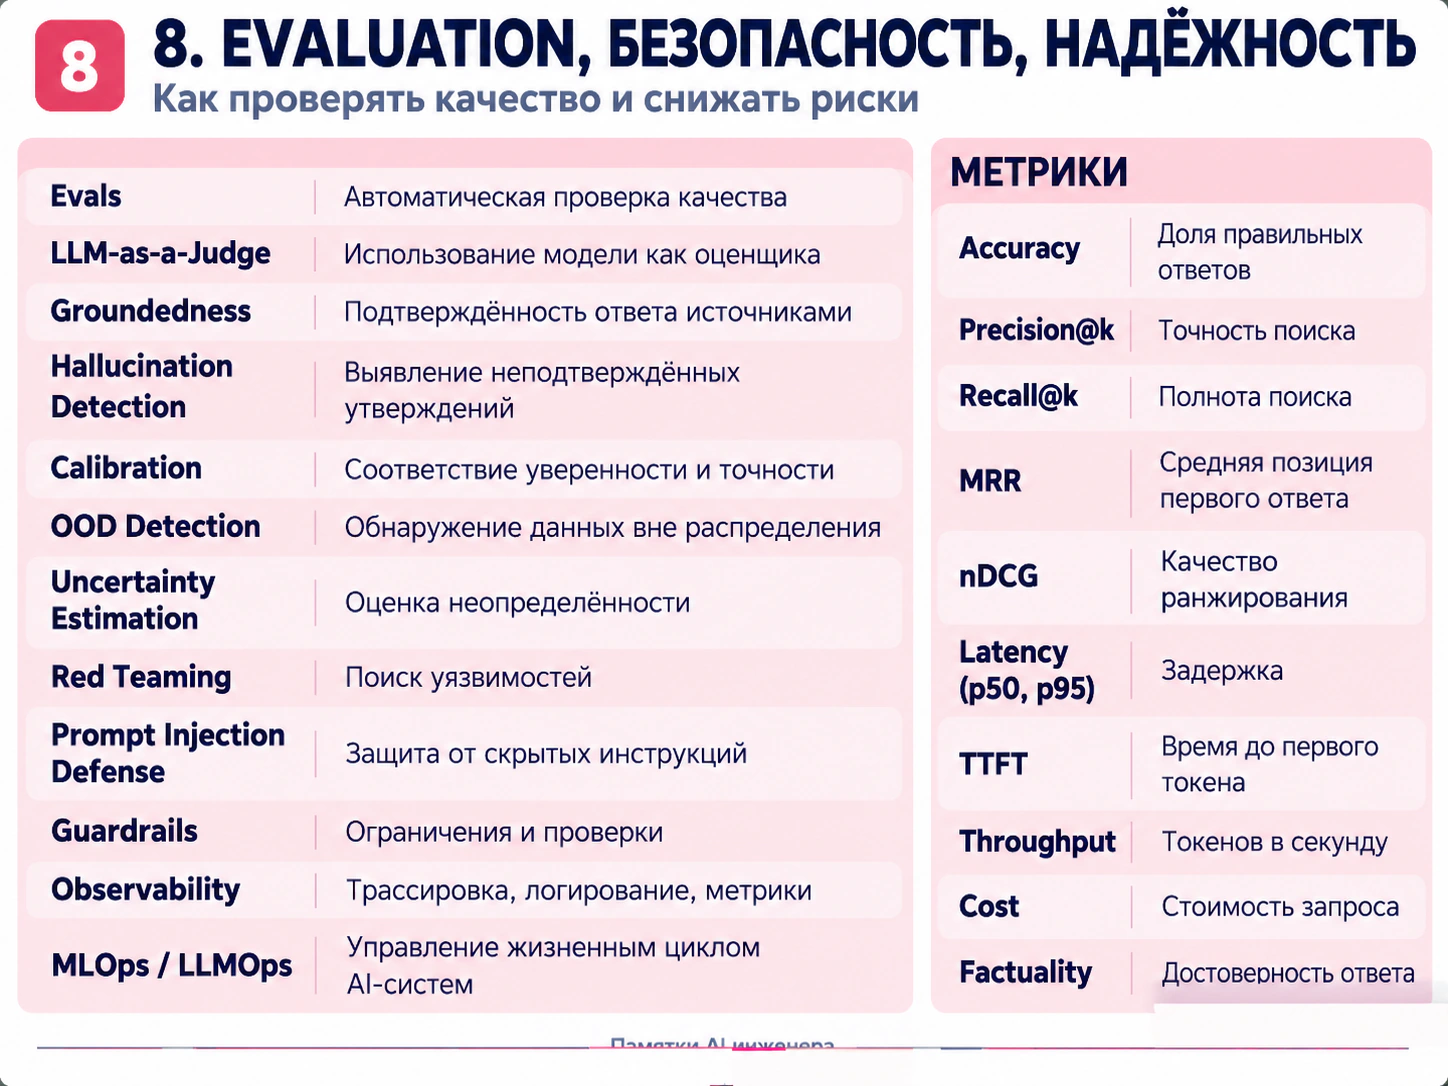
В схеме подпись MRR неточна: метрика усредняет обратную позицию первого релевантного результата, а не саму позицию.
Оценку начинаем с набора заданий и ожидаемого поведения. Для CMS нужны обычные вопросы, неоднозначные формулировки, отсутствующие инструкции, устаревшие документы и запросы к чужим данным. Один убедительный диалог не проверяет эти ситуации.
Поиск и генерацию измеряем отдельно. В поиске precision@k — доля релевантных результатов среди первых k; recall@k — доля найденных в этой выдаче релевантных документов от всех известных релевантных для запроса. Для расчёта нужна размеченная выборка и договорённость о том, что считать релевантным. Определения precision и recall.
MRR усредняет обратную позицию первого релевантного результата по запросам. Для отдельного запроса это 1/r, где r — место первого подходящего документа; если он не найден в оцениваемой выдаче, вклад равен нулю. MRR не измеряет полноту всех найденных сведений. Механика первого релевантного результата видна в реализации reciprocal rank в TorchMetrics.
Для ответа проверяем соответствие источникам, полноту необходимых шагов, корректный отказ и полезность ссылок. Можно привлекать другую модель как оценщика, но спорные случаи и критерии требуют человеческой проверки.
Документ способен содержать вредоносную инструкцию. Приложение должно обрабатывать найденный текст как данные, не предоставляя ему полномочий менять правила или вызывать инструменты. Дополняем это ограничением действий, проверками доступа и безопасным отображением результата.
Каждое изменение модели, инструкции или поиска прогоняем через сохранённый набор оценки. Новые ошибки добавляем как регрессионные примеры. Отдельно проверяем, что закрытые сведения не попадают в ответы, технические логи и кеши.
9. Фундамент: данные, математика и обычная разработка
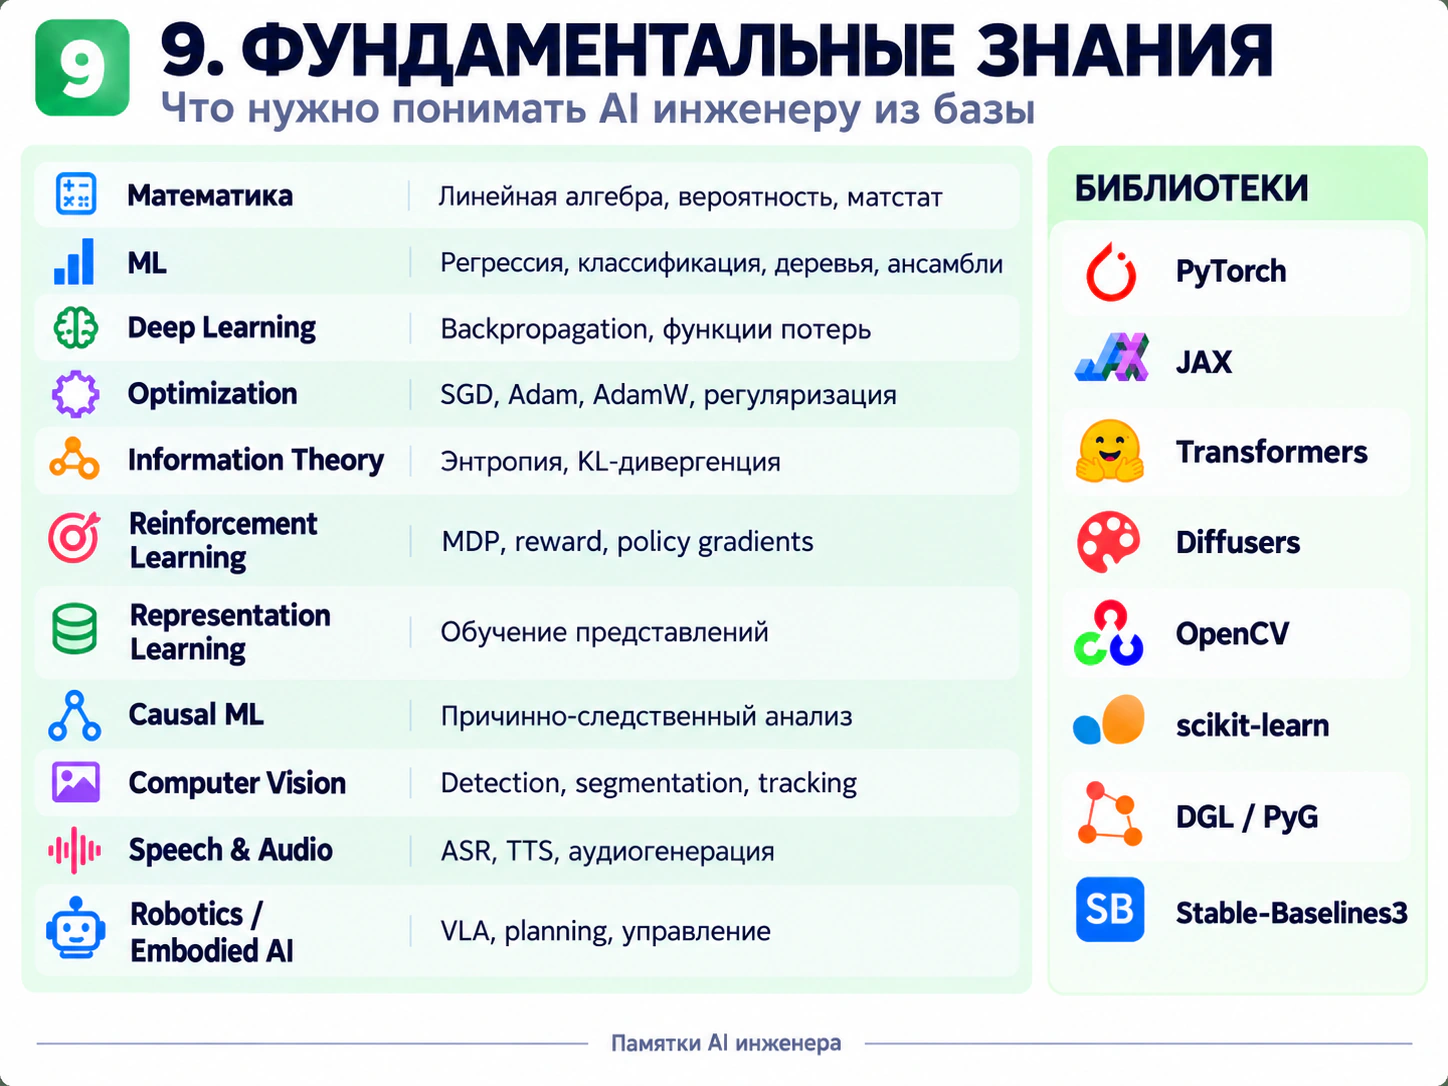
Для интеграции готовой модели не нужно сначала стать исследователем всех нейросетевых архитектур. Но полезно понимать векторы, сходство, вероятностный результат и границы статистической оценки. Это помогает отличить уверенный текст от подтверждённого утверждения.
Нужны и навыки обычной разработки: HTTP, хранение данных, очереди, тайм-ауты, разграничение доступа, наблюдаемость и управление конфигурацией. Приложение остаётся программной системой, даже если часть результата предлагает модель.
Для документации CMS особенно важна дисциплина данных. У инструкции должны быть владелец, версия и область применения. Удаление документа должно отражаться в поисковом индексе; изменение прав — в доступности фрагментов и кеша. Нельзя рассчитывать, что модель самостоятельно восстановит эти правила из названий файлов.
Проектирование начинаем с доступов и обезличенных примеров. Затем определяем, какие материалы допустимо отправлять внешнему поставщику, как долго хранить запросы и кому видны журналы. Секреты инфраструктуры не становятся учебными данными только потому, что рядом находится полезная инструкция.
Команде полезно разделить ответственность: редактор отвечает за содержание, разработчик — за приложение и интеграции, администратор — за доступ и эксплуатацию, владелец продукта — за критерии полезности. Один человек может совмещать роли, но сами обязательства должны оставаться понятными.
10. Архитектура AI-приложения: собрать проверяемый путь пользователя
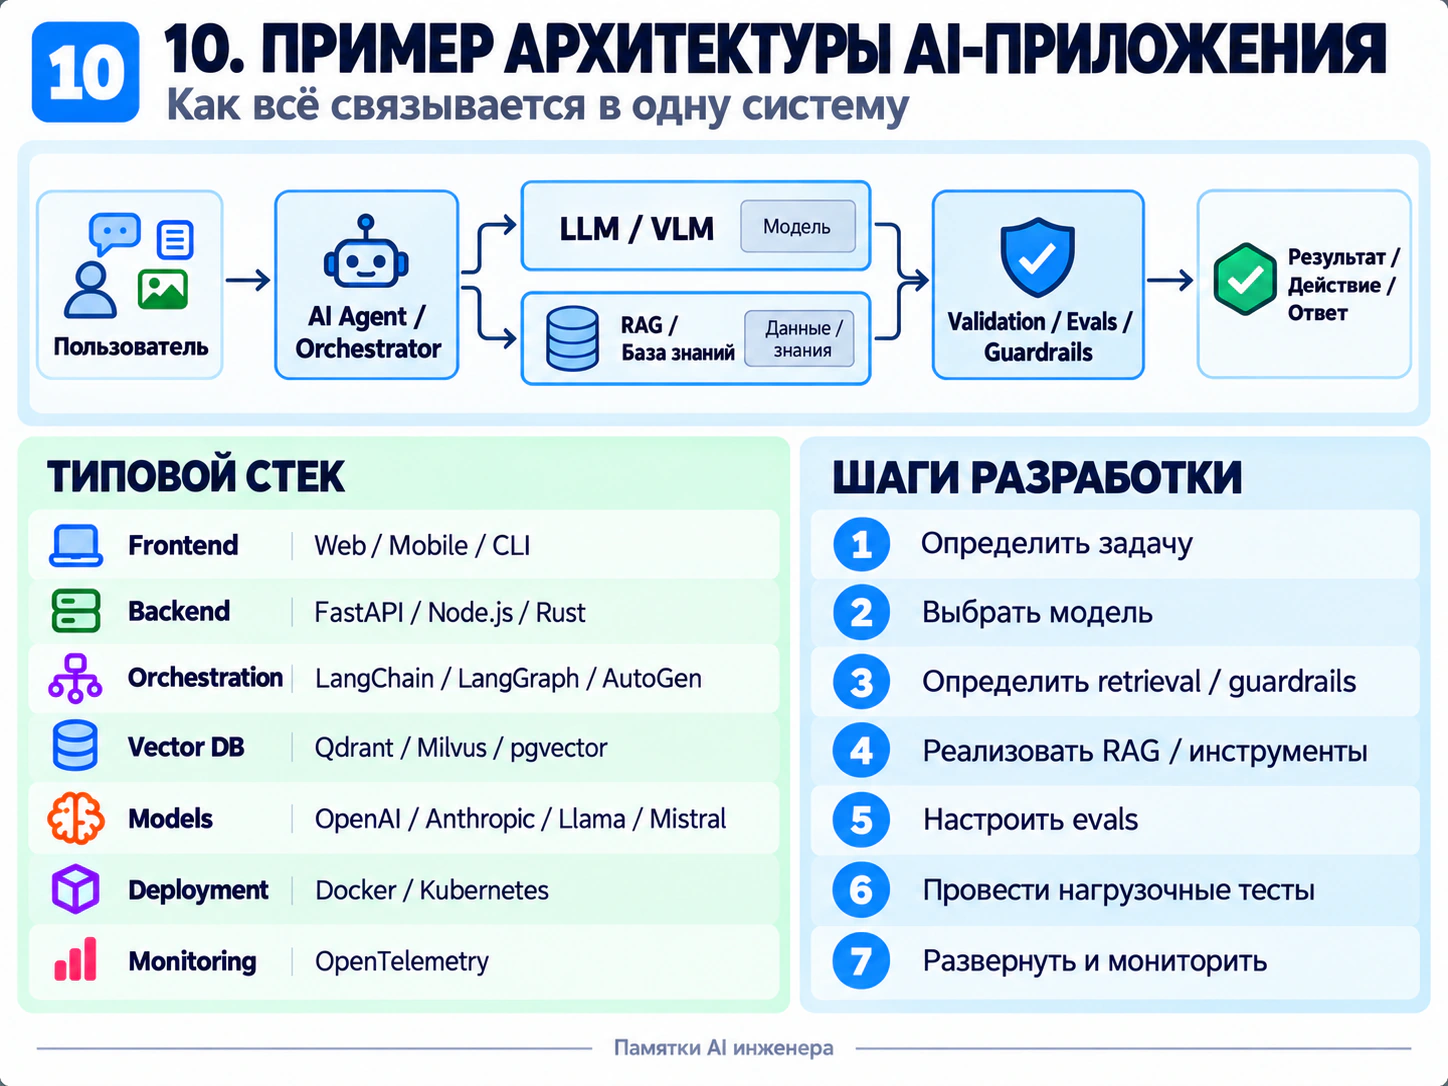
Для первой версии ассистента достаточно последовательного процесса: интерфейс принимает вопрос, сервер проверяет сессию и ограничения, поиск выбирает разрешённые фрагменты, модель формирует ответ, приложение возвращает текст и источники. Ошибки каждого этапа имеют понятное состояние для пользователя.
Индекс строится отдельной задачей из доверенных документов с метаданными и правами. Изменение материала запускает обновление, а отсутствие доступа исключает его из выдачи. Если индекс отстаёт, система должна учитывать это ограничение, а не показывать устаревший результат как актуальную инструкцию.
В журнале выполнения полезны идентификатор запроса, версии конфигурации, использованные источники, вызовы инструментов, задержки и расход. Полные личные данные и секреты для этого не обязательны. Доступ к подробностям ограничивается отдельно.
Публикацию новой версии начинаем с ограниченного сценария и возможности отключить проблемный компонент. При сбое генерации интерфейс может предложить найденные инструкции и обычный поиск. При недоступности проверки прав безопасный ответ не должен включать закрытые материалы.
Практический чек-лист перед запуском
- Определена одна задача и действие, которое должен выполнить пользователь.
- Подготовлены актуальные документы с владельцами, версиями и правами.
- Есть набор оценки поиска, ответов, отказов и попыток получить чужие данные.
- Инструменты ограничены разрешённым списком; изменяющие действия проверяются сервером.
- Установлены бюджеты, тайм-ауты и правила безопасных повторов.
- Кеш и журналы учитывают конфиденциальность, а обновления проходят регрессионную оценку.
- Пользователь видит источники и может продолжить работу при ошибке ассистента.
Частые вопросы
Нужно ли сразу дообучать модель? Нет. Сначала проверяем задачу на готовой модели, качественных инструкциях и актуальном поиске. Дообучение требует отдельного основания и данных для оценки.
RAG или агент? RAG помогает использовать найденные материалы, агентный цикл — выбирать действия. Они могут сочетаться, но для справочника часто достаточно поиска и одного ответа.
Как понять, что приложение готово? По заранее согласованным сценариям и ограничениям: ответ опирается на источник, права соблюдаются, ошибки понятны, расходы контролируются. Демонстрационный диалог этих условий не заменяет.
Начать стоит с небольшого, проверяемого пути от вопроса до полезного результата. Дальнейшее усложнение оправдано конкретной проблемой, обнаруженной при работе и оценке системы.